
生成AI・機械学習・大規模言語モデル(LLM)の急速な進化により、ITエンジニアのキャリア選択肢として「AIエンジニア」が現実的で高付加価値な道です。
従来のシステム開発スキルを活かしながら、より上流・高年収・高需要な領域へシフトできる点が最大の魅力です。
具体的には、従来のシステム開発者・ソフトウェアエンジニアが、どのようにすればAIエンジニアになれるのかを考えます。
私自身もこのような希望があり、今後、特に力を入れていきたい部分です。
AIエンジニアの仕事内容・必要スキルを一般論で把握し、分析をしていきます。
その上、学習方法について検討します。

AIエンジニアの定義
AIエンジニアを一般論で解説します。
AIエンジニアとは、人工知能(AI)技術(機械学習、深層学習など)を駆使して、データを分析・学習させ、人間のような判断や予測を行うシステムやソフトウェアを設計・開発・運用する専門家です。
今後のIT業界で注目度No.1の部門です。
スマートスピーカーの応答、動画のおすすめ表示、自動運転、医療診断支援など、AIが使われる様々な分野で、その頭脳となるプログラムを作り、「育てる」役割を担い、ビジネスの課題解決や新しい価値創造に貢献し、最先端技術の仕掛け人となります。
「人工知能(AI)技術(機械学習、深層学習など)を駆使」、「頭脳となるプログラムを育てる」とは、これらの意味について詳しく理解したいと思います。
人工知能(AI)技術(機械学習、深層学習など)を駆使するとは
大量のデータからコンピューターに特徴や規則性を学習させ、その結果を使って予測・分類・判断・生成などを行わせることを言います。
例えば、「犬と猫の写真を見分けるAI」を作る場合を考えてみます。
従来のプログラムでは、人間が、
「耳が、この形をしていれば猫」
「鼻が、この形をしていれば犬」
というような判定ルールを細かくプログラムする必要がありました。
一方、機械学習では、大量の「犬の写真」「猫の写真」と正解データをコンピューターに与えます。
コンピューターはデータから特徴やパターンを学習し、新しい写真を与えられたときに「犬である確率90%」などと予測できるようになります。
深層学習(ディープラーニング)は機械学習の一分野で、多層のニューラルネットワークを使い、画像・音声・文章などの複雑な特徴を学習します。
たとえば、
- 画像から人物や物体を認識する
- 音声を文章に変換する
- 過去の売上から将来の需要を予測する
- 不正な取引を検出する
- 文章を分類・要約する
- 質問に対する文章を生成する
といった処理があります。
つまり、「AI技術を駆使する」=AIという特殊なプログラムを書くことだけではなく、データを集め、学習させ、性能を評価し、実際のシステムで利用できる状態にすることまで含むと考えると分かりやすいでしょう。
頭脳となるプログラムを育てるとは
「育てる」というのは、本当にプログラムが人間のように成長するという意味ではありません。
データを与える → 学習させる → 性能を評価する → 問題を修正する → 再び学習させるという作業を繰り返して、AIモデルの精度や実用性を高めていくことを指します。
たとえば迷惑メールを判定するAIなら、
「迷惑メール1万件」
「通常メール1万件」
などのデータを用意して学習(プログラムに入力データを投入)させます。
最初のAIが100件中70件しか正しく判定できなかったとします。
そこでAIエンジニアが、
「学習データが足りないのでは?」
「データに偏りがないか?」
「モデルの設定を変更したほうがよいのでは?」
「別のアルゴリズムのほうが適しているのでは?」
などを検討します。
改善して再び学習させたところ、
70% → 85% → 92%
と精度が上がっていく。
このような工程を分かりやすく表現したのが、「AIの頭脳となるプログラムを育てる」です。
ただし、技術的には「プログラムを育てる」より、「AIモデルを学習・評価・改善する」という表現のほうが正確です。
AIエンジニアの役割
AIエンジニアの仕事は、単に「AIのプログラムを書く」ことではありません。
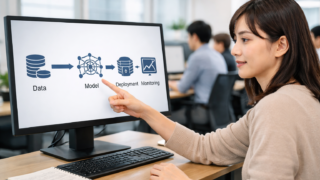
実務では、ビジネス課題を「AIで解く」ために、課題を決める → データを準備する → AIモデルを作る → 学習させる → 評価・改善する → システムに組み込む(デプロイ) → 運用する(運用改善)という一連の作業を担当します。
最近は生成AI活用(LLMアプリ、RAG、エージェント)と、MLOps基盤整備の重要度が上昇しています。
具体的にイメージするために、「商品の売上を予測するAI」を開発するモデルで解説します。
1.AIで解決する課題を決める
最初に「AIを使って何を実現するのか」を明確にします。
たとえば小売店から、「商品の仕入れ量を適正化して、売れ残りや品切れを減らしたい」相談を受けたとします。
そこでAIエンジニアは、「過去の販売実績などから翌日の商品ごとの販売数を予測する」という課題に落とし込みます。
いきなりプログラミングを始めるわけではありません。
「何を予測するのか」「どの程度の精度が必要なのか」「AIを使う必要があるのか」などを検討します。
2.AIに学習させるデータを集める
AIは何も知らない状態から勝手に賢くなるわけではありません。
学習の材料となるデータが必要です。
売上予測なら、
- 過去の販売数
- 商品
- 曜日
- 時間帯
- 価格
- セールの有無
- 天気
- 季節
- 在庫数
などのデータが必要と考えられます。
「どんなデータを使えば予測できそうか」を考えることもAIエンジニアの重要な仕事です。
3.データをAIが使える状態にする
集めたデータを、そのままAIに渡せるとは限りません。
たとえば、
8月1日 販売数 120
8月2日 販売数 ?
8月3日 販売数 135
8月4日 販売数 -10
というデータがあった場合、「?」という欠損値や「販売数 -10」という異常値をどう扱うか検討する必要があります。
重複データの削除、欠損値への対応、異常値の確認、データ形式の統一などを行います。
これをデータの前処理と呼びます。
実際のAI開発では、このデータ準備・前処理にかなりの作業時間が必要になることがあります。
4.AIモデルを選んでプログラムを作る
データが準備できたら、目的に適した機械学習の手法を選択します。
Pythonを使う場合なら、scikit-learn、PyTorch、TensorFlowなどのライブラリやフレームワークが利用されます。
ここで重要なのが、AIエンジニアが「知能そのもの」を一行一行プログラムしているわけではないという点です。
たとえば、
月曜日なら120個売れる
雨なら30個減らす
気温が30℃以上なら20個増やす
というすべてのルールを人間が記述するのではなく、データから規則性を学習できる仕組みを作るのが機械学習です。
5.AIモデルにデータを学習させる
実際の「学習」を行います。
例えば過去3年間のデータ(日付、曜日、天気、気温、価格、販売数)をAIモデルに与えます。
するとモデルは、データに含まれる複雑な関係を学習していきます。
イメージとしては、過去のデータ → AIモデル → パターンを学習 → 学習済みモデルという流れです。
これが、よく「AIの頭脳を育てる」と表現される部分です。
6.本当に予測できるかテストする
学習が終わったから完成、ではありません。
学習に使用していないデータで、「未知のデータでも正しく予測できるか?」を評価します。
たとえば実際の販売数が100個だった日に、
AI予測:98個
実際:100個
ならかなり近いでしょう。
一方、
AI予測:180個
実際:100個
なら改善が必要です。
AIの種類によって、Accuracy(正解率)、Precision(適合率)、Recall(再現率)、MAE(平均絶対誤差)、RMSE(二乗平均平方根誤差)など適切な評価指標を使います。
7.精度が悪ければ改善する
AIモデルを学習させても、最初から十分な精度が得られるとは限りません。
期待した結果が出ない場合、AIエンジニアは原因を分析し、モデルの性能を改善していきます。
ここがAIエンジニアの腕の見せどころです。
精度が悪ければ、「データが不足しているのではないか」「不要なデータが混ざっていないか」「別の特徴量を追加できないか」「モデルを変更したほうがいいのではないか」「ハイパーパラメータを変更したらどうか」などを検討します。
そして、データ準備 → 学習 → 評価 → 改善 → 再学習 を繰り返します。
したがって、「AIを育てる」という表現は、実際にはこの試行錯誤によってAIモデルの性能を高めていく作業を指していると考えます。
8.完成したAIをシステムに組み込む
精度の高いAIモデルができても、それだけでは利用者は使えません。
例えば売上予測AIアプリなら、
販売管理システム
↓
昨日までの販売データ
↓
AIモデル
↓
明日の販売予測
↓
「明日は120個必要です」
という仕組みにします。
Web APIとして提供したり、クラウド上で動かしたり、既存の業務システムから呼び出せるようにしたりします。
そのためAIエンジニアには、機械学習だけでなく、Pythonなどのプログラミング、データベース、Web API、Linux、クラウドなどの知識が求められる場合があります。
9.運用開始後もAIを監視・改善する
通常のシステムと同じように、AIもリリースしたら終わりではありません。
たとえば消費者の行動が変化すると、精度が以下のような状態になっていく可能性があります。
開発時:予測精度 92%
↓
半年後:86%
↓
1年後:78%
そこで新しいデータを収集し、必要に応じてモデルを再学習します。
このようなAIモデルの継続的な運用・監視・再学習も重要な仕事です。
普通のプログラマーとの違い
一般的なプログラミングでは、人間が処理ルールを考えてプログラムとして記述します。
【従来型のプログラム】
人間がルールを考える
↓
プログラムを書く
↓
データを入力する
↓
結果を得る
一方、機械学習では
【機械学習】
大量のデータ+正解例
↓
学習アルゴリズム
↓
データの規則性を学習
↓
学習済みAIモデル
↓
新しいデータ
↓
予測・分類
という考え方になります。
つまりAIエンジニアは、「答えを出すルールをすべて自分でプログラムする」のではなく、「データからルールや特徴を学習できる仕組みを作り、その性能を評価・改善する」ところに大きな特徴があります。
そして実務では、AIモデルを作ることだけでなく、課題設定、データ収集・前処理、プログラミング、モデル学習、精度評価、改善、システムへの実装、運用・再学習までがAIエンジニアの仕事になります。
「AI技術を駆使する」「AIの頭脳を育てる」がAIエンジニアの担当ですが、そのために豊富な知識と経験が必須となります。
なかなかハードルは高目です。
実務の流れと1日の例
| 工程 | 主な作業 |
|---|---|
| ①データ前処理 | 欠損処理、正規化、匿名化、ラベリング |
| ②特徴量/プロンプト | 特徴設計、プロンプト設計、評価指標設計 |
| ③モデル構築 | ML/DL、LLM活用、ハイパラ調整 |
| ④評価 | オフライン指標、A/B、回帰/分類/生成評価 |
| ⑤MLOps | CI/CD、監視、データ/モデルドリフト対策 |
※機械学習(Machine Learning:ML)、ディープラーニング(Deep Learning:DL)
①データ前処理
生データを機械学習モデルが学習しやすいように「きれいに整える」ための重要な工程。
欠損値の処理、外れ値の除去、データの正規化(スケール統一)、カテゴリ変数の数値化などを行い、データの品質を高めて分析・モデルの精度と効率を向上させる作業です。
分析時間の約8割を占めることもあり、料理の下ごしらえのように不可欠な作業です。
②特徴量/プロンプト
特徴設計(Feature Engineering, 特徴量設計)は、機械学習モデルの精度を向上させるため、生データから有用な「特徴量(説明変数)」を抽出し、数値形式に変換・加工するプロセスです。
ビジネス課題と関連性の高い特徴を見つけ出すことが重要。
データの種類(カテゴリ、時系列など)に応じて、エンコーディング、集計、結合などの手法が用いられ、AI・機械学習プロジェクトの成否を左右する重要な工程の一つです。
③モデル構築
モデルとは何なのか。
初心者ではピンときません。
AIでのモデルとは、「質問(プロンプト)に回答するツール」と考えていいでしょう。
その頭脳を、入力データによって構築していきます。
では、どのようにするのでしょうか。
モデル構築とは、前処理したデータを使って、予測・分類・生成などを行うAIモデルを作り、学習させる工程です。
まず、「何を実現したいのか」に応じて適切な機械学習・深層学習の手法を選びます。
たとえば、過去の売上から将来の売上を予測するなら「回帰」、メールが迷惑メールかどうかを判断するなら「分類」、文章を生成・要約するならLLM(大規模言語モデル)など、目的によって利用するモデルや技術が異なります。
そして、Pythonや機械学習ライブラリなどを使ってモデルを作成し、準備したデータを与えて学習させます。
このときAIエンジニアは、モデルを作るだけでなく、ハイパーパラメータの調整も行います。
ハイパーパラメータとは、学習率、学習回数、モデルの複雑さなど、AIの学習方法を調整するために人間が設定する値です。
つまりモデル構築とは、「目的に合ったAIの仕組みを選び、データを学習させ、より良い結果を出せるよう調整する作業」と考えると分かりやすいでしょう。
なおLLMを利用したシステムでは、必ずしもモデルそのものを一から学習させるわけではありません。
既存のLLMをAPIなどから利用し、プロンプト設計やRAG、必要に応じてファインチューニングなどを行って目的に合ったシステムを構築するケースもあります。
④評価
AIモデルを作ったら、次に「本当に正しく予測・分類・生成できるのか」を評価します。
ここで重要なのは、学習に使用したデータだけで判断しないことです。
学習時には成績が良くても、初めて見るデータでは正しく判断できない場合があります。
そのため、学習に使っていないテストデータなどを使って性能を確認します。
例えば迷惑メールを判定するAIなら、100件のメールのうち何件を正しく判定できたかを調べます。
分類問題では、Accuracy(正解率)、Precision(適合率)、Recall(再現率)、F1スコア(F値)などが代表的な評価指標です。
売上や価格などの数値を予測する回帰問題では、MAEやRMSEなどが使われます。
生成AIの場合は少し事情が異なり、単純な正解率だけでは十分に評価できません。
例えば、
「質問に正しく回答しているか」「事実と異なる内容を生成していないか」「指示に従っているか」「不適切な回答をしていないか」
などを、人による評価や自動評価を組み合わせて確認します。
表にある「A/B」は、2つのモデルやプロンプト、機能などを実際の利用環境で比較し、どちらがより良い結果を出すか確認するA/Bテストを意味します。
つまり評価とは、単に「AIが動いた」ことを確認するのではなく、「実際の利用環境でも十分な性能があるか」を客観的な指標やテストによって確認する工程です。
⑤MLOps
MLOps(Machine Learning Operations)とは、作ったAI・機械学習モデルを実際のシステムで継続的かつ安定して運用するための仕組みや取り組みです。
AIモデルは、一度完成したら終わりではありません。
例えば売上予測AIを作ったとします。
開発時には高い精度が出ていても、季節、商品の人気、顧客の行動などが変化すると、時間の経過とともに予測精度が低下することがあります。
そこで運用開始後も、モデルが正常に動いているか、予測精度が低下していないか、入力されるデータの傾向が変化していないかなどを監視します。
表にあるデータドリフトとは、AIを学習させたときのデータと、実際の運用時に入力されるデータの傾向が変化することです。
また、モデルドリフトは、環境や予測対象との関係などが変化し、モデルの予測性能が低下していく現象を指す場合に使われます。
問題が発生したら、新しいデータを使って再学習したり、新しいモデルに更新したりします。
そこで重要になるのが表にあるCI/CDです。
AIモデルやプログラムを変更するたびに、人間がすべて手作業でテストして本番環境へ配置すると、時間がかかりミスも発生します。
そのため、変更したプログラムやモデルについて、変更 → テスト → 検証 → 本番環境への反映といった工程を可能な範囲で自動化します。
これによってAIを「作って終わり」にせず、監視・評価・改善・再学習・更新を継続して、安全かつ安定的に利用できる状態を維持するのがMLOpsの重要な役割です。
1日の例(フレックス):進捗確認→前処理→昼→モデル検証→関係者MTG→チューニング→デプロイ。
必要スキル
- 基礎:Python、統計/確率、線形代数、SQL
- ML/DL:scikit-learn、PyTorch/TensorFlow、評価指標
- 生成AI:LLM、RAG、プロンプト設計、評価フレーム
- MLOps:Docker、GitHub Actions、MLflow、監視
- クラウド:AWS/GCP/Azure、GPU、ストレージ/ネットワーク
- 横断:ドメイン理解、要件定義、ドキュメント/可視化
基礎となるPythonは、ひたすらプログラミング。
一方、数学は、工業系大学の1・2年生で履修する一般教養科目レベルのおさらいをする。
この壁は厚いが、チャレンジし甲斐がある。
年収・将来性
- 年収目安:中堅で500~700万円台、上位で800万円~も
- 将来性:高。生成AIの実装・評価・運用改善の人材需要が拡大
- 注意:PoC止まりを避け、継続的改善(MLOps)で事業貢献へ
学習ロードマップ(未経験→実務)
- 基礎固め:Python/NumPy/Pandas、SQL、統計
- 古典ML(古典的機械学習、Traditional Machine Learning):教師あり/なし学習、特徴量、交差検証
- DL/生成AI:PyTorch、LLM基礎、RAG、小規模PoC
- MLOps:Docker、CI/CD、MLflow、監視、再現性
- 実績化:GitHubにノートブック・レポジトリ公開、技術記事
おすすめ教材
- 書籍:ゼロから作るDL、Python機械学習プログラミング
- 講座:Udemyの実践コース/Kaggle入門
- 実践:小規模データでエンドツーエンド(End-to-End: E2E)(前処理→モデル→監視)
キャリアと関連リンク
- 横展開:データエンジニア/MLOpsエンジニア/AIプロダクトマネージャー
- 関連記事:機械学習ロードマップ/MLOps入門/IT職種一覧
まとめ
AIエンジニアは、人工知能や機械学習を活用してビジネス課題を解決する、今後ますます需要が高まる職種です。
仕事内容は、データ分析・モデル開発・システム実装まで幅広く、高度なスキルが求められる一方で、その分だけ市場価値も高いのが特徴です。
AIエンジニアとして活躍するためには、Pythonなどのプログラミングスキルに加え、数学や統計の知識、そして実務での経験が重要になります。
特に近年は、製造業や医療、金融など幅広い分野でAI活用が進んでおり、活躍の場は大きく広がっています。
これから目指す方は、基礎スキルの習得から始め、実践的な開発経験を積み重ねていくことが成功への近道です。
焦らず段階的にスキルを高めていくことで、将来性の高いAIエンジニアとしてキャリアを築くことができるでしょう。
AIエンジニアは「技術で未来を創る」魅力的な職業です。
本記事を参考に、自分に合った学習ステップを見つけ、次の一歩を踏み出してみてください。
よくある質問(FAQ)
- Q数学が苦手でもAIエンジニアになれますか?
- A
基礎統計と線形代数の要点を押さえれば、十分に実務へ進めます。
最初から高度な数学を完璧に理解する必要はなく、必要になった箇所を案件や学習の中で深掘りしていく姿勢が大切です。
- QKaggleは必須ですか?
- A
必須ではありません。
ただし、ベースライン作成・評価・改善の流れを実践的に鍛えるのに有効です。
実務に近い形で学びたい方には、Kaggleや小規模な分析コンペの活用は大きなプラスになります。
- Q生成AIはどのように学べばよいですか?
- A
まずはLLM(Large Language Model:大規模言語モデル)の基本とRAG(検索拡張生成)を最低限学ぶのがおすすめです。
そのうえで、自社データや業務想定データを使った評価フローを作る力まで身につけると、実務価値に直結しやすくなります。


コメント